Un sito Plone lento può risultare perfettamente online e, nello stesso momento, funzionare male. Una pagina risponde lentamente, una ricerca impiega troppo tempo o un portale rallenta soltanto in certe condizioni. Il problema più difficile non è sempre accorgersene: è capire dove si perde tempo.
Con plone.observability 1.1.0, pubblicato il 18 settembre 2026, una singola richiesta può essere seguita lungo l’intera infrastruttura: dall’ingresso del traffico al frontend Volto, dal backend Plone fino alle singole interrogazioni PostgreSQL nelle configurazioni compatibili.
Non rende il sito automaticamente più veloce. Fa però qualcosa di essenziale: sostituisce le ipotesi con dati osservabili.
Che cos’è plone.observability
plone.observability è un componente per Plone 6.2 progettato per controllare salute e prestazioni delle installazioni in container. La prima versione stabile, pubblicata il 14 settembre 2026, ha introdotto tre strumenti principali:
- controlli separati per sapere se l’applicazione è avviata, funzionante e pronta a ricevere traffico;
- metriche esportabili verso Prometheus;
- tracciamento opzionale con OpenTelemetry.
Il precedente controllo @@ok poteva rispondere “OK” senza verificare davvero che il database fosse raggiungibile. Inoltre, se tutti i processi ordinari erano occupati, anche il controllo rischiava di non rispondere. Il nuovo componente utilizza un canale dedicato e fornisce segnali più utili ai sistemi di monitoraggio e orchestrazione.
Cosa aggiunge la versione 1.1.0
La versione 1.1.0 nasce da una domanda molto concreta: possiamo vedere ingresso, cache, frontend, backend e database come un’unica traccia distribuita?
La risposta ora è sì. La nuova guida ufficiale descrive il percorso completo attraverso:
- Traefik, che apre la traccia quando arriva la richiesta;
- Varnish, che conserva e inoltra il contesto della traccia;
- Volto, il frontend React di Plone, osservabile tramite la strumentazione automatica di OpenTelemetry per Node;
- il backend Plone, che si collega automaticamente alla traccia in ingresso;
- PostgreSQL, quando viene utilizzato attraverso componenti compatibili come zodb-pgjsonb e psycopg 3.
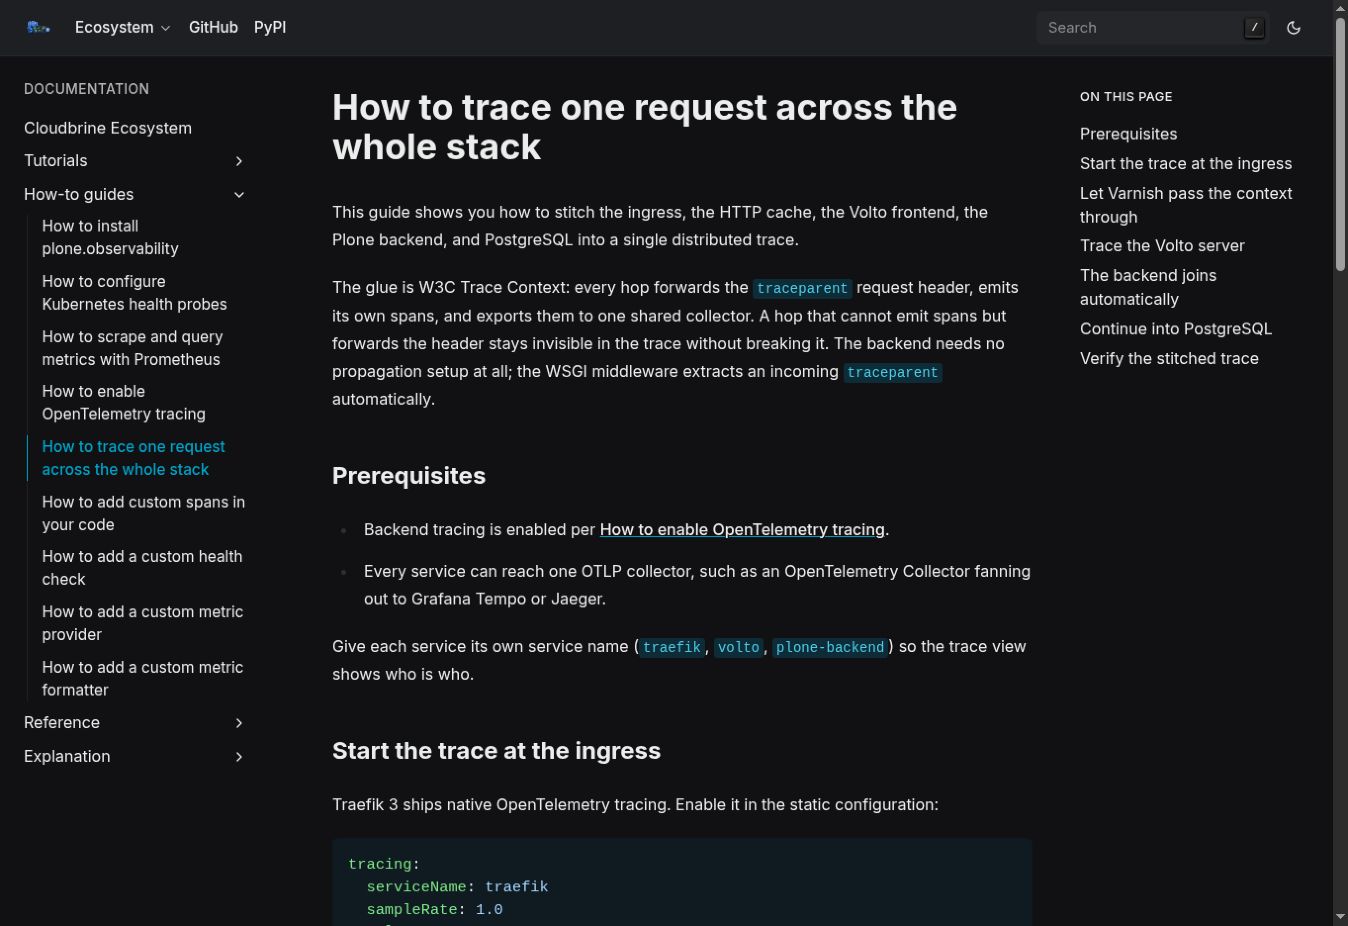
Il collegamento tra i diversi passaggi utilizza il formato standard W3C Trace Context. Ogni componente riceve e inoltra l’intestazione traceparent, aggiungendo le proprie misurazioni alla stessa storia.
Dal clic alla query SQL
Quando un utente apre una pagina, la richiesta può attraversare più livelli. Senza una traccia unica, ciascun livello produce informazioni separate: il frontend sembra lento, Plone registra una richiesta lunga, PostgreSQL mostra una query impegnativa. Mettere insieme i pezzi richiede tempo e spesso si procede per esclusione.
Con il tracciamento distribuito, la richiesta viene rappresentata come una sequenza di intervalli temporali, chiamati span. Diventa possibile vedere:
- quanto tempo si ferma all’ingresso;
- se la cache risponde oppure lascia passare la richiesta;
- quanto impiega Volto a generare la pagina;
- quali operazioni vengono eseguite nel backend;
- quanto pesano ricerche nel catalogo, trasformazioni e commit;
- quali query SQL vengono eseguite e quanto durano.
La novità della versione 1.1.0 è soprattutto l’opzione opentelemetry-db: nelle installazioni supportate, ogni istruzione SQL può diventare un elemento figlio della richiesta principale. Se il rallentamento nasce nel database, non resta nascosto dietro un generico “Plone è lento”.
Perché è importante per chi gestisce un portale
Un portale aziendale o istituzionale raramente è composto da un solo elemento. Può includere proxy, cache, frontend, backend, database, storage esterno e servizi di terze parti. Ogni componente può essere sano da solo e produrre comunque un’esperienza lenta quando lavora con gli altri.
plone.observability aiuta a:
- rilevare un problema prima che siano gli utenti a segnalarlo;
- distinguere un rallentamento del frontend da uno del backend o del database;
- individuare richieste, ricerche e personalizzazioni costose;
- ridurre il tempo necessario per formulare una diagnosi;
- verificare se un intervento ha prodotto un miglioramento reale;
- fornire a Kubernetes segnali affidabili per escludere o riavviare un’istanza non pronta.
È particolarmente utile nei progetti complessi che abbiamo raccontato nei nostri casi di studio Plone, dove continuità del servizio e tempi di risposta non sono dettagli tecnici, ma parte della qualità percepita da migliaia di persone.
Non è un pulsante “velocizza il sito”
È importante evitare un equivoco: installare il componente non migliora automaticamente le prestazioni. Occorre configurare la raccolta dei dati, scegliere dove inviare metriche e tracce e stabilire cosa osservare senza accumulare informazioni inutili.
Per il tracciamento completo servono inoltre componenti compatibili. La guida ufficiale propone, tra gli altri, un collector OpenTelemetry e strumenti come Grafana Tempo o Jaeger per consultare le tracce. Per arrivare fino a PostgreSQL occorrono psycopg 3 e l’instrumentor opzionale; la visibilità dettagliata dipende quindi dall’architettura effettiva del progetto.
Anche la percentuale di richieste da tracciare va scelta con attenzione. Registrare tutto può essere utile durante una diagnosi mirata, ma in produzione può aumentare costi e volume dei dati. L’osservabilità funziona quando le misurazioni rispondono a domande precise.
Quali problemi può aiutare a individuare
Un sistema del genere diventa concreto davanti a situazioni come queste:
- la homepage è rapida, ma la ricerca interna è lenta;
- alcune pagine Volto impiegano molto più tempo di altre;
- una personalizzazione genera troppe interrogazioni al database;
- un servizio esterno rallenta la risposta del portale;
- un’istanza risulta attiva, ma non è realmente pronta a servire traffico;
- un aggiornamento sembra avere peggiorato le prestazioni, ma manca una misura confrontabile.
Nel recente approfondimento su Volto Light Theme 8.0 abbiamo visto come componenti riutilizzabili e test automatici rendano più sostenibile l’evoluzione del frontend. L’osservabilità completa il quadro: non controlla soltanto che il componente appaia correttamente, ma aiuta a misurare ciò che accade quando l’intero sistema lavora.
Un nuovo modo di fare manutenzione
La manutenzione tradizionale interviene spesso dopo una segnalazione: qualcuno telefona, descrive un rallentamento e inizia la ricerca. L’osservabilità permette di spostarsi verso una manutenzione preventiva e misurabile.
Non significa eliminare l’esperienza tecnica. Significa metterla nelle condizioni di lavorare meglio. I dati indicano dove guardare; l’esperienza serve per capire perché il problema nasce e quale intervento sia sostenibile.
Se il tuo portale Plone è lento, presenta rallentamenti intermittenti o deve garantire maggiore continuità, redomino offre una consulenza Plone per aziende e organizzazioni per analizzare l’architettura, individuare le priorità e definire un percorso di intervento basato su dati reali.
Domande frequenti su plone.observability
Che cos’è plone.observability?
È un componente per Plone 6.2 che aggiunge controlli di salute, metriche e tracciamento OpenTelemetry alle installazioni in container.
plone.observability rende Plone più veloce?
No. Non accelera automaticamente il sito: aiuta a capire dove nasce un rallentamento e a verificare l’effetto degli interventi.
Qual è la differenza tra la versione 1.0.0 e la 1.1.0?
La 1.1.0 aggiunge il tracciamento opzionale fino alle singole query PostgreSQL e una guida per collegare ingresso, Varnish, Volto, Plone e database in un’unica traccia.
Che cos’è una traccia distribuita?
È la ricostruzione temporale di una singola richiesta mentre attraversa più componenti. Mostra quanto tempo viene impiegato in ogni passaggio.
Serve usare Volto?
No. Il backend può essere osservato anche senza Volto. La guida completa include Volto perché è una configurazione frequente nelle installazioni Plone moderne.
Serve PostgreSQL?
No. Controlli, metriche e tracciamento del backend restano utili anche senza PostgreSQL. Le tracce delle singole istruzioni SQL richiedono invece una configurazione compatibile.
È compatibile con Prometheus?
Sì. Il componente espone metriche in formato Prometheus e JSON attraverso un endpoint dedicato.
Può funzionare con Kubernetes?
Sì. Offre controlli distinti di liveness, readiness e startup, utilizzabili dalle sonde di Kubernetes per capire se un’istanza è viva, pronta o ancora in avvio.
Quali strumenti visualizzano le tracce?
La documentazione cita collector OpenTelemetry e backend come Grafana Tempo o Jaeger. La scelta dipende dall’infrastruttura già presente.
È adatto a tutti i siti Plone?
È pensato per Plone 6.2 su Python da 3.10 a 3.14, soprattutto in ambienti containerizzati. Prima dell’adozione occorre verificare versione, architettura e obiettivi di monitoraggio.
Fonti
- Annuncio di plone.observability 1.1.0 nella community Plone
- Guida ufficiale: tracciare una richiesta lungo l’intero stack
- Configurazione ufficiale del tracciamento OpenTelemetry
- Configurazione delle sonde Kubernetes
- Repository ufficiale di plone.observability
La schermata presente nell’articolo proviene dalla documentazione ufficiale di plone.observability.