«Abbiamo trovato la saetta per accelerare l’AI. Adesso dobbiamo decidere se usarla per lavorare ancora o per finire prima di lavorare.»
Da sapere in breve
- La novità per noi: abbiamo iniziato a provare la modalità rapida di Codex, attivabile e disattivabile dalla saetta.
- Il vantaggio: risposte del modello più veloci; le attese di siti e strumenti esterni possono restare.
- I due numeri: la nostra schermata indica velocità 1,5×; la quota inclusa viene consumata a un ritmo di 2,5× rispetto a Standard.
- Il test è iniziato: dobbiamo ancora misurare tempo risparmiato, qualità del risultato e consumo.
- Se sei un cliente Redomino, ci pensiamo noi.
Valuteremo dove questa opzione è utile nei flussi di lavoro e nelle configurazioni concordate, una volta verificati benefici e consumi.
 Se sei un cliente Redomino, ci pensiamo noi.
La latenza: quel mostro balordo che si mangia la giornata
Chi lavora via internet conosce il personaggio. Hai un’idea, fai una richiesta e aspetti. Il sito carica, il servizio risponde, l’assistente elabora. Il cursore gira con una serenità che tu, nel frattempo, hai perso.
Si chiama latenza: il ritardo tra una richiesta e l’arrivo della risposta. Nel lavoro quotidiano conta anche l’attesa necessaria per ottenere il risultato completo. Tante piccole pause possono spezzare il filo del ragionamento: apri un’altra scheda, controlli un messaggio e al ritorno devi ricordarti da dove eri partito.
Il 14 ottobre 2026 abbiamo iniziato a testare Fast mode, la modalità rapida di Codex, l’agente di intelligenza artificiale (AI) di OpenAI usato soprattutto per lavorare sul software. È un’opportunità che stiamo esplorando adesso: il primo passo è stato attivarla, non certificare un record di produttività.
Una saetta da accendere quando serve
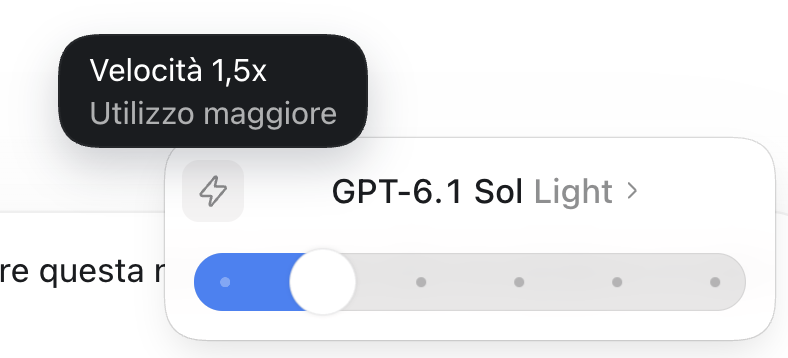
Nell’interfaccia che stiamo usando basta cliccare sulla saetta accanto al modello per attivare o disattivare la modalità rapida. Questa flessibilità è interessante: possiamo provarla quando siamo lì ad aspettare la risposta e tornare a Standard quando la velocità conta meno. Disponibilità e controlli dipendono da modello, piano e versione dell’app.
Secondo la documentazione ufficiale OpenAI, Fast accelera i modelli supportati mantenendo le loro capacità. La velocità è un’impostazione distinta dal livello di ragionamento. Ricerche sul web, caricamenti e operazioni di servizi esterni conservano però i propri tempi.
Per chi lavora per tentativi e correzioni, il beneficio potenziale è concreto: ridurre la pausa tra un’idea, una prima versione e la modifica successiva può aiutare a mantenere il ritmo. Quanto aiuti davvero nel nostro lavoro, lo misureremo.
1,5× più veloce e 2,5× di consumo: attenzione ai numeri
Il nostro screenshot mostra «Velocità 1,5x». Significa la velocità indicata per quella configurazione; non promette che ogni progetto finisca in due terzi del tempo. Una parte del lavoro resta fatta di verifiche, decisioni e attese esterne.
Il 2,5× riguarda invece il consumo della quota inclusa nell’abbonamento, rispetto a Standard con lo stesso modello. La pagina prezzi OpenAI distingue questo valore dal moltiplicatore sui crediti acquistati, pari a 2×. Le tariffe per chi usa una propria chiave API seguono condizioni separate.
La saetta, insomma, ha un appetito. Per capire se conviene, confronteremo attività simili con lo stesso modello e livello di ragionamento, annotando durata, risultato utilizzabile e quota consumata. Il contatore si consulta nella sezione Utilizzo dell’app; dove disponibile, anche il comando /usage apre le relative impostazioni.
Vale anche la domanda scomoda: chi vende il servizio ha interesse a vendere maggiore velocità. È legittimo valutarne il prezzo. Questo, da solo, non dimostra che la modalità standard venga rallentata apposta. Per noi il criterio resta il tempo utile recuperato rispetto al consumo aggiuntivo.
Più lavoro oppure più spiaggia?
Qui arriva il dubbio imprenditoriale. Se l’AI accelera, riempiamo subito lo spazio con altre attività? Lavoriamo “2,5 volte di più”? Quel numero non misura la produttività, ma la tentazione di trasformare ogni minuto libero in un nuovo compito è molto reale.
Oppure finiamo prima. Andiamo in spiaggia, facciamo una passeggiata, incontriamo qualcuno. Ci divertiamo. Una proposta vagamente scandalosa per il foglio delle attività.
Per noi conservare tempo per staccare fa parte del mantenersi lucidi. Il mestiere richiede giudizio: scegliere una direzione, accorgersi di un errore, capire quando fermarsi. Avere più risposte disponibili serve se manteniamo anche l’attenzione necessaria per valutarle.
È coerente con il nostro manifesto Tempo Vita e con il Metodo Redomino: cerchiamo strumenti che migliorino concretamente il lavoro e restituiscano tempo alle persone. La scelta di come usarlo resta nostra. La saetta, per fortuna, non prenota la prossima riunione.
Due domande prima di lasciarla accesa
Conviene tenere sempre attiva la modalità rapida?
Dipende da quanto riduce l’attesa nelle attività che svolgi e da quanta quota hai disponibile. Il nostro esperimento parte dall’uso a bisogno: la convenienza continuativa è ancora da verificare.
Avete già misurato il risparmio di tempo?
No. Abbiamo iniziato la prova e documentato il controllo nell’interfaccia. Il prossimo passo è confrontare risultati, tempi e consumi su attività simili. Nessun “lavoriamo 2,5 volte di più” da aggiungere oggi alla presentazione aziendale.
Fonti e prova sul campo
- Prova Redomino del 14 ottobre 2026: attivazione della modalità rapida e screenshot fornito da Giuseppe Masili.
- OpenAI: modalità di velocità e modelli supportati.
- OpenAI: utilizzo incluso, crediti e moltiplicatori.
- OpenAI: comandi e accesso alle impostazioni di utilizzo.
Qual è l’attesa che ti spezza più spesso la giornata? Parliamone in un Momento Redomino: capire dove si perde tempo viene prima di acquistare un altro acceleratore.