Aggiornamento del 31 ottobre 2026. Google e Microsoft hanno annunciato un segnale condiviso per dire che i contenuti di un sito non devono essere usati per addestrare modelli di intelligenza artificiale. Il meccanismo non è ancora operativo: Google punta al 2027; Microsoft inizierà a rispettarlo dal 1° febbraio 2027.
Da sapere in breve
- Che cosa cambia. Diventa possibile separare con più precisione tre scelte: comparire nella ricerca, essere usati come fonte nelle risposte AI e permettere l’addestramento dei modelli.
- Quando. Oggi è un annuncio, non una funzione già attiva. Microsoft indica il 1° febbraio 2027; Google parla più genericamente del 2027.
- Che cosa non cambia. Vietare l’addestramento non dovrebbe togliere il sito dai risultati tradizionali di Bing. Per Google restano attivi i controlli attuali, compreso Google-Extended, fino al nuovo supporto.
- Il limite. Il segnale comune è descritto in un Internet-Draft individuale discusso nel gruppo AI Preferences dell’IETF, non è uno standard definitivo, e ogni fornitore deve dichiarare se e come lo rispetterà.
Cosa cambia per chi gestisce un sito?
Proprietario del sito: potrà dire “non usare i miei contenuti per addestrare i modelli” senza rinunciare automaticamente alla presenza nei risultati di ricerca. La separazione diventerà effettiva soltanto quando i fornitori inizieranno a rispettare il nuovo segnale.
Responsabile marketing o comunicazione: potrà scegliere separatamente la visibilità nelle risposte AI. Con Microsoft, impedire il grounding, cioè l’uso della pagina come fonte per costruire una risposta, ridurrà anche citazioni e possibilità di visita dalle esperienze AI.
Tecnico o agenzia: prima di modificare robots.txt, meta tag o intestazioni HTTP dovrà distinguere addestramento, grounding e indicizzazione. Per esempio, sarà possibile vietare l’addestramento ma lasciare consentito l’uso della pagina come fonte.
Decisione utile oggi: non copiare ancora nuove regole nel sito. Conviene invece verificare se sono presenti NoArchive, NoCache o regole specifiche per i crawler AI e pianificare la transizione indicata da Microsoft.
La novità del 30 ottobre 2026: un segnale comune per l’addestramento AI
Google, Microsoft e il gruppo di lavoro AI Preferences dell’Internet Engineering Task Force (IETF) stanno convergendo su una sintassi comune dentro robots.txt. Il token proposto è __usage_ai-training: usa le normali regole Allow e Disallow per esprimere una preferenza sull’addestramento per tutto il sito o per singoli percorsi.
La proposta tecnica è descritta in un Internet-Draft individuale pubblicato il 30 ottobre 2026 e discusso nel gruppo AI Preferences dell’IETF. Il Datatracker precisa che il documento non è approvato dall’IETF e non ha una posizione formale nel processo di standardizzazione. Nel testo dell’autore compare l’obiettivo “Standards Track”, ma oggi non è un RFC né uno standard definitivo. Inoltre non blocca tecnicamente l’accesso del crawler: comunica una preferenza sull’uso del contenuto. Le normali regole per consentire o vietare la scansione restano separate.
Google prevede di supportare il segnale nel 2027. Se un sito userà il segnale comune per vietare l’addestramento e non specificherà diversamente Google-Extended, Google intende trattarlo come un divieto a Google-Extended. Le regole specifiche per singoli fornitori continueranno a funzionare. Google precisa inoltre che consentire Google-Extended rende i contenuti idonei al grounding nelle app Gemini, ma non garantisce citazioni o clic.
Microsoft separa addestramento e uso come fonte
Microsoft ha pubblicato il calendario più concreto. Dal 1° febbraio 2027 inizierà a rispettare due preferenze indipendenti:
- AI Training: uso del contenuto per modificare i parametri di un modello generativo; configurabile per sito, percorso o singola pagina.
- AI Grounding: uso della pagina come fonte per costruire una risposta generata; configurabile per singola pagina con
Allow,DisallowExtendedoDisallow.
DisallowExtended mantiene il grounding nelle esperienze gestite direttamente da Microsoft, come Copilot e Microsoft 365, ma lo esclude dai servizi di grounding forniti a terzi. Disallow lo impedisce in tutte le esperienze coperte. Nessuna delle due scelte modifica l’idoneità ai normali risultati di Bing, ma limitare il grounding riduce la visibilità nelle risposte AI. Microsoft non promette presenza, traffico o compensi nemmeno quando il grounding è consentito.
Le date da segnare per i siti che usano NoArchive o NoCache
Per i siti che oggi usano NoArchive o NoCache, Microsoft indica una transizione precisa:
- 15 dicembre 2026: apertura in Bing Webmaster Tools di una preferenza temporanea per il grounding, riservata ai siti che usano già quei controlli.
- 1° febbraio 2027: inizio del rispetto delle nuove preferenze quando Microsoft esegue una nuova scansione.
- 1° marzo 2027: termine entro il quale pubblicare le nuove preferenze; dopo questa data
NoArchiveeNoCachenon saranno più letti come segnali per addestramento o grounding. - 30 settembre 2027: scadenza delle preferenze temporanee, oppure prima se la pagina viene nuovamente scansionata.
La configurazione non diventa attiva nel momento in cui viene scritta: Microsoft deve prima rilevarla durante una nuova scansione. IndexNow può segnalare la modifica della pagina, ma non garantisce quando avverrà il nuovo passaggio.
Domande frequenti sulle nuove preferenze AI nei siti
Il nuovo segnale AI Training in robots.txt è già operativo?
No. Il segnale comune per vietare l’addestramento AI è stato proposto il 30 ottobre 2026 in un Internet-Draft individuale discusso nel gruppo AI Preferences dell’IETF. Google prevede di supportarlo nel 2027; Microsoft inizierà a rispettarlo dal 1° febbraio 2027.
Vietare l’addestramento AI farà sparire un sito da Google o Bing?
Non automaticamente. Microsoft afferma che le nuove preferenze per addestramento e grounding non cambiano l’idoneità ai risultati tradizionali di Bing. Google manterrà separati i controlli specifici e collegherà il nuovo segnale a Google-Extended, non alla normale indicizzazione in Google Search.
Qual è la differenza tra AI Training e AI Grounding per un sito?
AI Training indica l’uso dei contenuti per modificare i parametri di un modello generativo. AI Grounding indica invece l’uso della pagina come fonte mentre un sistema costruisce una risposta. Vietare il grounding può ridurre citazioni, link e visite dalle esperienze AI; vietare l’addestramento riguarda la costruzione dei modelli futuri.
Chi usa NoArchive o NoCache su Bing deve modificare il sito?
Sì, se vuole conservare le restrizioni su addestramento o grounding dopo il 1° marzo 2027. Microsoft chiede di pubblicare le nuove preferenze e, per il grounding, usare anche la transizione temporanea in Bing Webmaster Tools quando applicabile.
Fonti dell’aggiornamento
- Google Search Central, 30 ottobre 2026: supporto previsto per il segnale condiviso
- Microsoft Bing, 30 ottobre 2026: preferenze per addestramento e grounding
- IETF Datatracker: Internet-Draft individuale sul Machine-Readable Training Preference Signal, 30 ottobre 2026
Bloccare l’intelligenza artificiale dal proprio sito può sembrare semplice.
“Non voglio che utilizzi i miei contenuti. La blocco.”
Il problema è che alcuni sistemi automatici utilizzati per leggere il Web possono svolgere più di una funzione.
E dal 15 settembre 2026 una modifica introdotta da Cloudflare rende questa distinzione ancora più importante.
Perché bloccando qualcosa che non vogliamo potremmo rischiare di bloccare anche qualcosa che ci serve.
Prima di tutto: cos’è un crawler?
Quando Google visita automaticamente una pagina per scoprirla e inserirla nel proprio motore di ricerca utilizza un programma chiamato crawler.
Possiamo immaginarlo come un piccolo esploratore automatico che gira continuamente per il Web, legge le pagine e comunica al proprio sistema cosa ha trovato.
Con l’arrivo dell’intelligenza artificiale, però, questi esploratori possono avere obiettivi molto diversi.
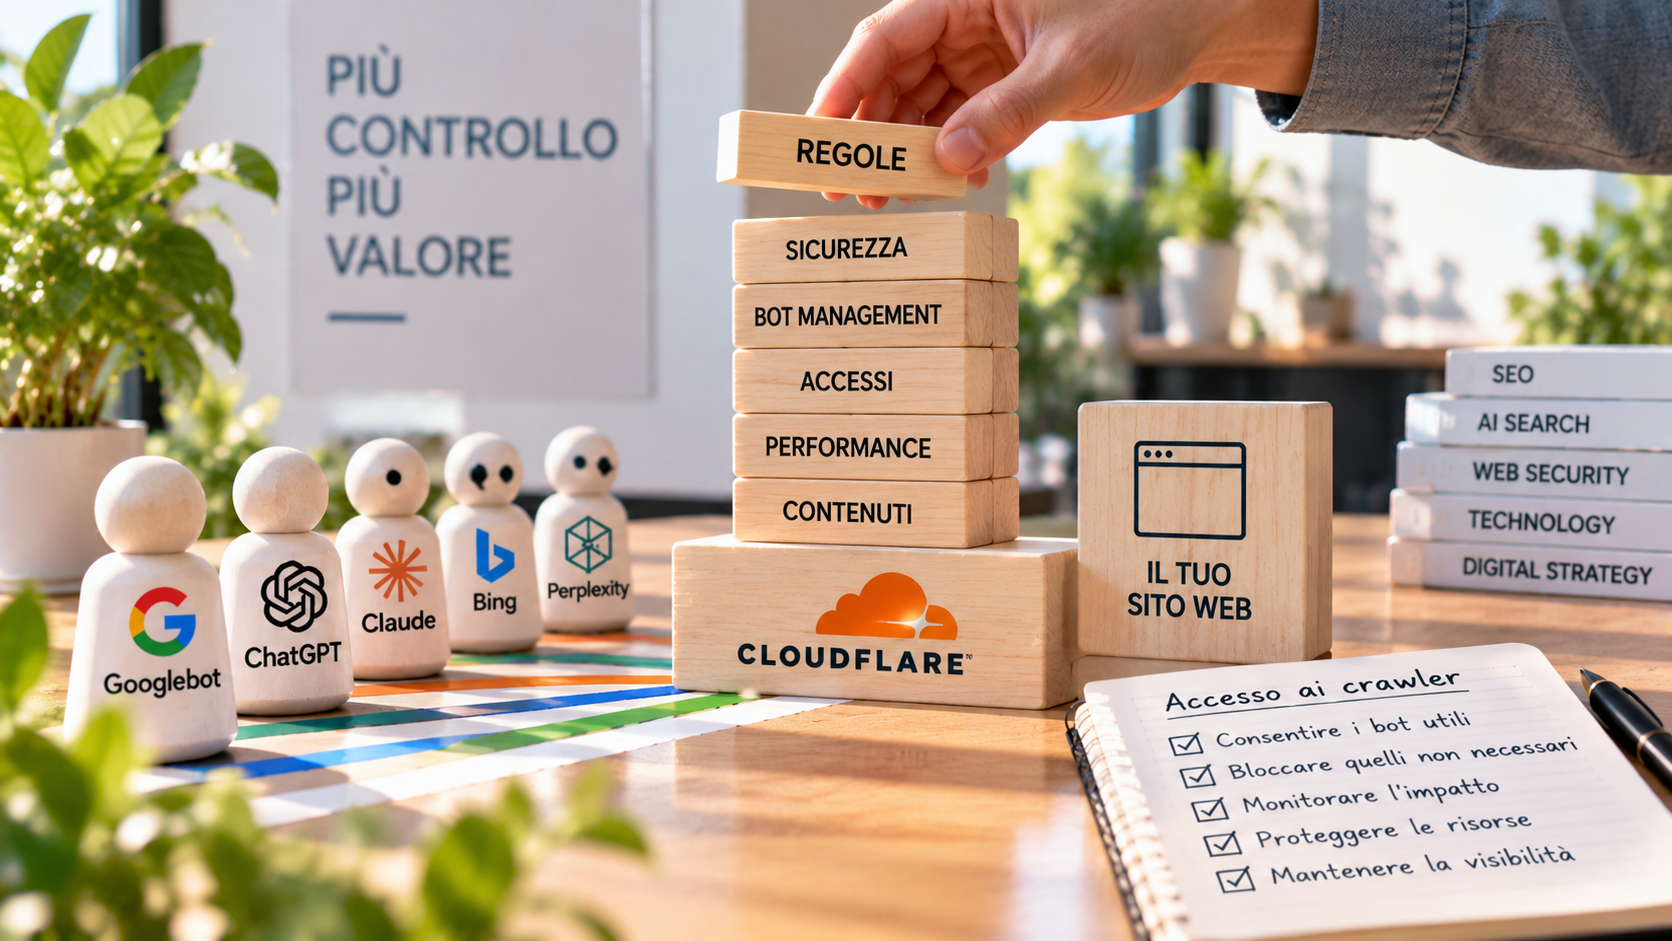
Cloudflare ha deciso di distinguerli in tre grandi categorie.
Search: visita il sito per permettere successivamente alle persone di trovarne i contenuti attraverso una ricerca.
Agent: visita una pagina in tempo reale perché una persona ha chiesto a un’intelligenza artificiale di svolgere un’attività.
Training: raccoglie informazioni che possono essere utilizzate per addestrare o migliorare un modello di intelligenza artificiale.
Sembrano differenze tecniche.
In realtà riguardano direttamente chiunque possieda un sito.
Il problema: lo stesso crawler può fare più cose
La situazione si complica quando lo stesso crawler svolge più funzioni.
Cloudflare cita, tra gli esempi, Googlebot, BingBot e Applebot.
Con le nuove regole, quando un crawler appartiene contemporaneamente a categorie differenti può essere applicata la regola più restrittiva.
Ed ecco il rischio.
Un’azienda potrebbe decidere:
“Non voglio che i miei contenuti vengano utilizzati per addestrare l’intelligenza artificiale.”
Una scelta perfettamente legittima.
Ma una configurazione troppo restrittiva potrebbe avere conseguenze anche sull’accesso necessario ad altre funzioni, compresa la ricerca.
In altre parole:
attenzione a non chiudere la porta all’intelligenza artificiale e scoprire di averla chiusa anche a Google.
Bloccare l’AI non è più un semplice sì o no
La vera novità è probabilmente questa.
Fino a poco tempo fa ragionavamo soprattutto così:
Google può leggere il mio sito oppure no?
Adesso dobbiamo iniziare a porci domande più precise.
Voglio che il mio sito venga trovato nei motori di ricerca?
Voglio che ChatGPT o un altro assistente possa consultarlo quando un utente fa una domanda?
Voglio permettere che i miei contenuti vengano utilizzati per addestrare un modello?
Sono tre decisioni differenti.
Ed è importante che le impostazioni tecniche del sito riflettano esattamente ciò che vogliamo ottenere.
Il Web sta cambiando anche dietro le quinte
Cloudflare sta facendo qualcosa di apparentemente tecnico, ma il segnale è importante.
Il Web sta iniziando a distinguere non soltanto chi accede a un contenuto, ma anche perché lo sta facendo.
Per chi si occupa di SEO, cioè ottimizzazione per i motori di ricerca, e di visibilità nelle risposte generate dall’intelligenza artificiale, questa distinzione diventerà sempre più importante.
La regola pratica, però, rimane semplicissima.
Prima di bloccare un crawler perché contiene la parola “AI”, controlliamo bene che cosa fa.
Perché proteggere i propri contenuti è legittimo.
Renderli involontariamente invisibili è tutta un’altra storia.